장기·오목·알까기를 화면으로 옮기며 내린 결정들
칼럼 · 2026-10-08 · GamePool 편집팀
장기, 오목, 알까기는 2026년 10월 1일(오목)과 10월 8일(장기·알까기)에 GamePool에 들어왔습니다. 규칙은 세 게임 모두 오래된 놀이인데, 컴퓨터가 상대를 해야 하는 순간부터는 규칙마다 선택이 필요했습니다. 어디까지 규칙대로 막고, 어디서부터 단순화할 것인지입니다. 이 글은 전통 놀이의 장단점을 일반론으로 비교하는 대신, 세 게임의 소스(public/games 아래 janggi, omok, alkkagi)에 실제로 들어 있는 값과 결정만 적었습니다.
장기 AI는 앞을 1수, 3수, 5수 읽습니다
장기의 컴퓨터는 알파-베타 가지치기를 쓰는 탐색입니다. 난이도에 따라 읽는 깊이가 달라서, 쉬움은 1수, 보통은 3수, 어려움은 5수까지 봅니다. 여기에 시간 제한이 붙어 있습니다. 쉬움 0.3초, 보통 1.2초, 어려움 2.6초가 지나면 탐색을 끊고 직전에 끝낸 깊이의 결과를 둡니다. 1수부터 차례로 깊이를 늘려 가는 방식이라 시간이 모자라도 최소한 앞 단계의 답은 남습니다. 어려움이 5수까지 가려면 기기가 빨라야 하므로, 느린 휴대폰에서는 5수 대신 3~4수 깊이에서 끊길 수 있습니다. 같은 어려움이어도 기기에 따라 실력이 달라지는 한계입니다.
말의 가치는 사 3, 상 3, 마 5, 포 7, 차 13, 졸 2로 두었습니다(궁은 잡히면 끝이라 0으로 두고 별도 처리). 평가식은 여기에 100을 곱한 값에 위치 보정을 더합니다. 차는 포의 약 두 배, 졸은 사의 3분의 2입니다. 쉬움과 보통의 실력 차이는 깊이뿐 아니라 점수에 섞는 무작위 값에서도 납니다. 쉬움은 각 수의 점수에 0~160의 무작위를 더하고, 보통은 0~12를 더하며, 어려움은 더하지 않습니다. 말 가치가 졸 200, 사·상 300인 점수 체계에서 160은 졸 하나를 쉽게 놓치는 수준이고, 12는 사실상 동점 상황에서 수를 고르는 정도입니다. 그래서 쉬움은 눈앞의 졸이나 사를 종종 흘리고, 보통은 거의 흘리지 않습니다.
탐색 안쪽에서는 장군 판정을 따로 하지 않습니다. 대신 궁을 잡는 수를 만나면 곧바로 이긴 것으로 점수를 매깁니다. 이렇게 하면 모든 노드마다 장군 검사를 하지 않아도 되어 계산이 빨라집니다. 규칙 검사는 현재 판에서 가능한 수를 뽑는 맨 위 단계에서만 합니다. 그곳에서는 내 궁이 장군에 걸리는 수와 두 궁이 마주 보게 되는 수(빅장)를 둘 수 없는 수로 걸러 냅니다. 피할 수 없는 장군은 외통으로 패배 처리합니다. 빅장은 이 구현에서 그 수를 아예 두지 못하게 막는 쪽으로 단순화했습니다.
장기에서 사람이 하는 일과 컴퓨터가 하는 일
사람은 초(녹색), 컴퓨터는 한(빨강)으로 정해져 있습니다. 상차림은 사람이 네 가지(마상마상, 마상상마, 상마상마, 상마마상) 중에서 고르고, 컴퓨터 쪽은 판을 새로 시작할 때마다 네 가지 중 무작위로 정해집니다. 사람이 말을 누르면 갈 수 있는 칸에 표시가 뜹니다. 터치 입력에서는 교차점에서 칸 간격의 0.62배보다 멀리 눌리면 입력으로 치지 않습니다. 장기판은 선 위의 교차점에 말을 놓기 때문에, 교차점에서 너무 먼 곳을 누르면 아무것도 선택하지 않도록 한 값입니다.
무르기 버튼(Ctrl+Z)은 내 수와 컴퓨터의 수를 한 쌍으로 되돌립니다. 컴퓨터가 생각하는 중이거나 기록이 두 수 미만이면 동작하지 않습니다. 잡힌 말 목록도 함께 되돌려서 되돌리기 이후 판 상태와 사망한 말 표시가 어긋나지 않게 했습니다. 이 기능을 넣은 이유는 학습용입니다. 승수는 랭킹에 올라가는데 무르기를 썼는지는 기록하지 않으므로, 기록을 의미 있게 하고 싶다면 쓰지 않는 규칙을 스스로 정하는 수밖에 없습니다.
오목: 금수 없이 6목도 인정
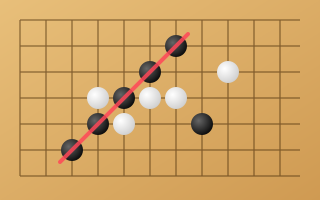
오목은 15×15 판에서 사람이 항상 흑으로 먼저 두고 컴퓨터가 백입니다. 승리 판정 코드는 가로·세로·두 대각선 방향으로 같은 색 돌이 5개 이상 이어졌는지만 봅니다(길이 5 이상). 그래서 5목뿐 아니라 6목, 7목도 승리로 인정합니다. 삼삼·사사·장목 같은 금수 판정은 구현에 없습니다. 정식 렌주 규칙은 흑에게 이런 제한을 두지만, 이 게임에서는 사람이 흑을 쥐고 컴퓨터와 두는 구조여서 금수 판정 코드를 넣지 않고 규칙을 단순하게 두었습니다. 이 선택의 결과로 흑이 불리해지는 장면이 없으니, 어려움 단계에서도 사람이 열린 3과 열린 3을 동시에 만드는 수는 합법입니다.
컴퓨터는 각 빈칸의 가치를 점수표로 계산합니다. 한 방향의 연속 돌 수와 양끝의 열림 개수로 점수를 매기는데, 열린 4(양끝이 비어 있는 4)는 100만점, 한쪽만 막힌 4는 2만점, 열린 3은 2만점, 한쪽 막힌 3은 1,500점, 열린 2는 400점 식입니다. 5목은 1,000만점입니다. 한 칸 띈 모양(돌-빈칸-돌)도 인식하지만, 한 칸 띈 다섯은 승리가 아니라 사목으로 취급해 다시 점수를 줍니다. 두 방향 이상에서 1,500점 이상의 모양이 동시에 생기는 칸에는 3만점을 더해 삼삼·사삼 같은 겹치는 공격을 우선합니다. 후보는 기존 돌에서 2칸 이내의 빈칸으로 제한해서 15×15 전체를 보지 않고도 빠르게 고릅니다.
난이도는 공격과 수비 가중치와 무작위, 그리고 한 수 더 보기로 나뉩니다. 쉬움은 공격 0.8, 수비 0.6으로 수비에 덜 신경 쓰고, 최상위 점수가 2만점 미만일 때는 상위 3개 후보 중 무작위로 고릅니다(상대가 다음 수에 5목을 만들 수 있을 때는 점수가 2만점을 훌쩍 넘어 무작위를 쓰지 않고 바로 막습니다). 보통은 공격 1.15, 수비 0.95입니다. 어려움은 공격 1.15, 수비 1.05에 더해 상위 6개 후보마다 내가 두었다고 가정하고 상대의 최고 응수 점수를 구해 (내 점수 - 상대 응수 점수 × 0.6)이 가장 큰 수를 둡니다. 읽는 깊이로 보면 2수입니다. 장기 AI의 5수에 비하면 얕지만, 점수표가 열린 3 같은 패턴을 이미 점수로 알아보기 때문에 얕게 읽어도 기본 공방은 합니다. 승수는 승리할 때마다 올라가고 닉네임 랭킹에 누적 승수로 등록됩니다.
알까기: 마찰과 반발 값
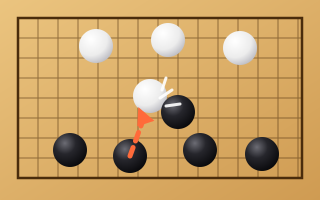
알까기의 물리는 숫자 다섯 개로 정해집니다. 판 한 변은 1,000, 최대 당김 길이는 260이고, 당긴 길이에 6.2를 곱한 값이 출발 속도입니다. 최대로 당기면 초속 1,612입니다. 마찰은 두 부분입니다. 속도와 상관없이 일정하게 깎는 560과 속도에 비례해 깎는 1.2배(속도 × 1.2)를 더한 값이 초당 감속량입니다. 속도가 14 아래로 내려가면 그대로 멈춥니다. 반발 계수는 0.94이고, 같은 크기의 돌 두 개가 부딪히면 충돌 방향 속도 차이의 (1 + 0.94) ÷ 2만큼씩을 서로 주고받습니다. 돌의 중심이 판 밖으로 나가면 떨어진 것으로 처리하고, 떨어지는 동안(0.9초)에는 다른 돌과 충돌하지 않습니다.
이 값으로 시뮬레이션해 보면 당김 세기에 따른 이동 거리가 나옵니다. 최대 세기의 100%로 당기면 약 1.2초 동안 763 단위, 판 한 변의 4분의 3 가까이 미끄러집니다. 85%는 609, 70%는 462, 55%는 325, 40%는 200입니다. 거리는 세기에 정비례하지 않고 제곱에 가깝게 늘어납니다. 세기를 40%에서 100%로 2.5배 올리면 거리는 200에서 763으로 약 3.8배가 되는데, 속도와 무관한 일정한 마찰이 있기 때문입니다. 컴퓨터도 이 계산을 그대로 씁니다. 사람이 겨냥선의 색(초록에서 빨강)으로 세기를 가늠하는 것과 달리 컴퓨터는 같은 물리 코드로 결과를 미리 돌려 봅니다.
돌 개수에 따라 돌 크기도 바뀝니다. 5개일 때 반지름 37, 7개일 때 34, 9개일 때 31입니다. 돌이 많을수록 작게 만들었습니다. 5개 판은 돌이 크고 빠르게 끝나며 9개 판은 작은 돌이 빽빽하게 몰려 있어 한 번의 충돌이 연쇄적으로 번집니다.
알까기 AI는 모든 후보를 미리 굴려 봅니다
알까기 컴퓨터는 내 돌 하나와 상대 돌 하나를 짝지어 그쪽으로 쏘는 후보를 만들고, 각 후보를 진짜 물리 함수로 90분의 1초 단위, 최대 700걸음까지 돌려서 결과를 점수로 매깁니다. 상대 돌이 떨어지면 돌당 100점, 내 돌이 떨어지면 돌당 -130점이고, 살아남은 돌이 판 가장자리 150 이내에 있으면 위험도에 따라 상대 돌에는 가산(최대 14), 내 돌에는 감산(최대 18)을 합니다. 내 돌의 손실을 상대 돌의 이득보다 1.3배 무겁게 쳐서, 컴퓨터가 무리한 맞교환보다 안전한 수를 고르게 했습니다.
난이도별로 후보 수가 다릅니다. 쏘는 세기 후보가 쉬움 2개(55%, 80%), 보통 4개(45~100%), 어려움 5개(40~100%)이고, 어려움에서는 각 후보에 방향을 -0.04, 0, +0.04 라디안씩 틀어 세 갈래로 나눠 봅니다. 돌이 7개씩이면 짝지을 수 있는 쌍이 49개이므로 후보는 쉬움 98개, 보통 196개, 어려움 735개의 시뮬레이션이 됩니다. 쉬움은 점수 상위 5개 중 무작위로 하나를 고르고 점수에도 최대 60의 무작위를 섞습니다. 마지막으로 사람처럼 손이 떨리게 만들어, 발사 각도에는 쉬움 ±0.12, 보통 ±0.045, 어려움 ±0.012 라디안의 오차를, 세기에는 같은 비율의 오차를 줍니다. 어려움 오차 0.012라디안은 700 단위 거리에서 약 8 단위 빗나가는 정도로, 돌 지름(68)의 8분의 1 남짓이라서 어려움은 거의 빗나가지 않습니다.
승부 규칙에서 내린 작은 결정들
알까기는 한쪽 돌이 모두 떨어지면 끝납니다. 양쪽이 같은 걸음에 함께 떨어지면 무승부로 처리합니다. 내 차례에는 내 돌만 선택할 수 있고, 컴퓨터가 생각하는 650밀리초 동안은 입력을 막습니다. 2인용 모드는 한 화면에서 번갈아 쏘는 방식이라 전적과 랭킹에는 반영하지 않고, 컴퓨터를 상대로 이길 때만 승수를 올립니다. 오목 컴퓨터는 사람이 둔 280밀리초 뒤에 둡니다.
이 승수 기록에는 알까기에서 실제로 발견한 오류가 얽혀 있었습니다. 승패 처리 함수가 게임 종료 뒤에도 프레임마다 다시 불려서, 이긴 뒤에 승리 횟수가 계속 올라가고 효과음이 반복됐습니다. 이 횟수를 랭킹에 보고하는 호출이 같은 자리에 있어서, 구조상 부풀려진 승수가 랭킹으로 전송될 수 있었습니다. 원인은 진행 단계 값이 sim으로 남아 있어 같은 판정이 되풀이되는 것이었고, 종료 여부를 먼저 확인해 돌아가도록 한 줄을 추가하고 단계를 idle로 바꿔서 해결했습니다(10월 8일). 규칙 구현보다 상태 전이를 닫는 일이 더 까다로웠다는 것이 알까기에서 얻은 교훈입니다.
디지털로 옮기며 잃은 것과 아직 부족한 것
- 장기 AI의 5수 읽기는 기기 성능에 따라 깊이가 달라지고, 쉬움의 160점 무작위는 정답을 일부러 틀리게 만든 것이라 사람처럼 실수하는 느낌이 부족합니다.
- 오목은 금수가 없어 프로 규칙을 배우려는 사람에게는 맞지 않고, 컴퓨터가 점수표와 2수 읽기에만 의존하므로 긴 포석을 계획하지는 못합니다.
- 알까기는 손가락 힘 대신 당기는 길이로 세기를 정하므로, 겨냥선과 최대 길이(260)에 익숙해지는 시간이 필요합니다.
- 세 게임 모두 무르기와 표시 기능이 실제 대국의 긴장감을 줄입니다. 대신 실수한 수를 바로 되돌려 보며 배울 수 있다는 점은 디지털에서만 가능했습니다.
전통 놀이를 화면에 옮길 때 가장 오래 걸린 일은 규칙 구현이 아니라 컴퓨터 상대를 사람답게 만드는 일이었습니다. 숫자 몇 개로 실력을 조절할 수 있지만(읽는 수 1·3·5, 오차 ±0.12·0.045·0.012, 공격 가중치 0.8·1.15), 사람과 둘 때의 표정이나 훈수는 만들 수 없었습니다. 그래서 알까기에는 한 화면에서 둘이 겨루는 2인용 모드를 남겨 두었습니다.